Видео-версия: ролик собирали ИИ-агенты, голос — мой клон в ElevenLabs.
Я нанимаю ИИ-агентов вместо сотрудников и каждый день вижу, как они ошибаются. Чаще всего это не «ложь»: модель подбирает правдоподобное продолжение, и если ей не на что опереться, она угадывает. Ниже три случая, механика и метод, который помогает мне не попадаться.
Три случая, где угадывание стоило денег
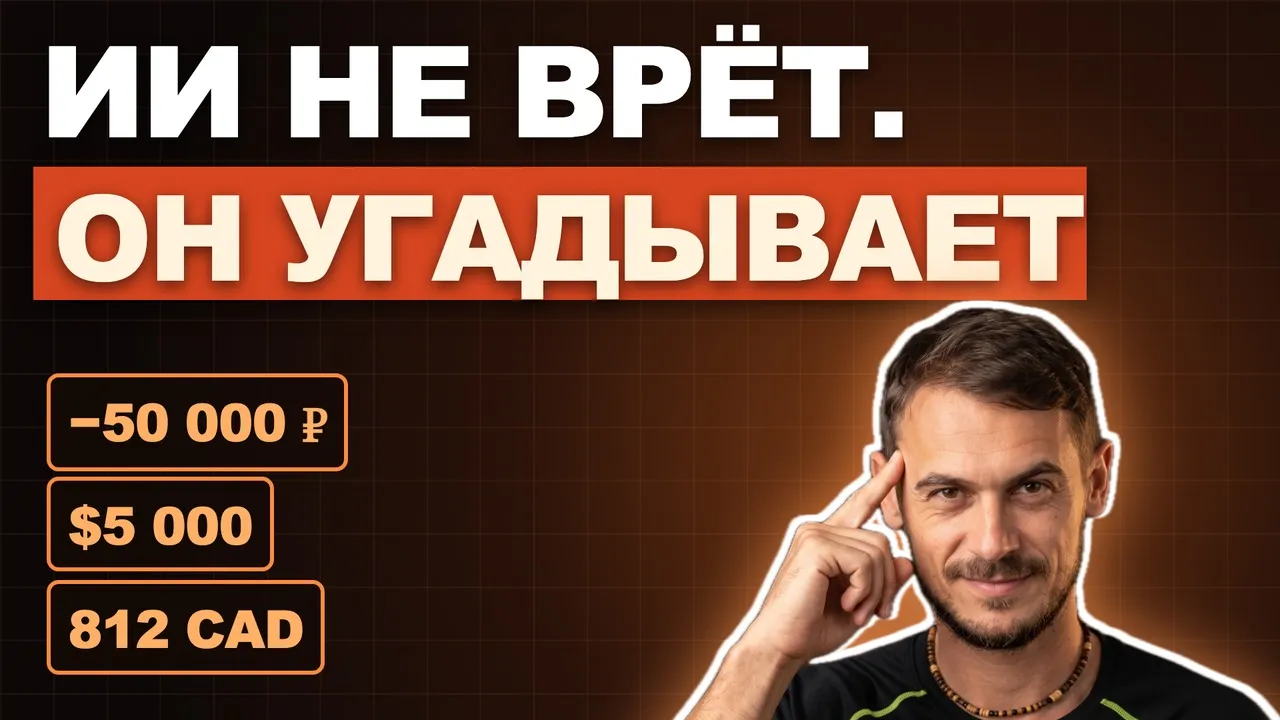
Краснодар и виза. По данным News.ru (со ссылкой на Telegram-канал SHOT) семья из Краснодара спросила ChatGPT, нужна ли виза в Северную Македонию. Ответ был «не нужна». Их не пустили на посадку в Турции, билеты сгорели, потери оценивают примерно в 50 тысяч рублей. Это пересказ СМИ, оригинал SHOT я не открывал, поэтому цифру считаю ориентиром: News.ru.
Mata v. Avianca. В 2023 году адвокаты в Нью-Йорке подали в суд документ с несуществующими решениями, которые сгенерировал ChatGPT. Суд наложил санкцию 5 000 долларов. Суд отдельно отметил: в использовании надёжного ИИ-инструмента самом по себе нет ничего предосудительного, но проверять должен юрист. Определение суда.
Air Canada. Чат-бот авиакомпании посоветовал оформить скидку на похоронный тариф задним числом, хотя политика компании этого не допускала. Трибунал Британской Колумбии (Moffatt v. Air Canada, 2024 BCCRT 149) обязал выплатить 812,02 канадского доллара. Авиакомпания утверждала, что не отвечает за слова бота. Решение.
Суммы небольшие. Важнее другое: во всех трёх случаях ответ звучал уверенно, а проверить его никто не успел.
Что говорят исследования
- Университет Мельбурна и KPMG опросили более 48 тысяч человек в 47 странах: доверять системам ИИ готовы только 46%, при этом 66% пользуются им регулярно (отчёт).
- USENIX Security 2025 проверил 576 тысяч образцов кода от 16 моделей: 19,7% рекомендованных пакетов оказались вымышленными (статья). Каждая пятая библиотека, которую советует модель, не существует.
- Reuters Institute: еженедельное использование ИИ для получения информации выросло с 11% до 24% (отчёт).
Пользуются всё больше, доверяют меньше половины. Люди делятся на два лагеря. Одни верят с первого раза: американка Julie Neis выбрала, где жить во Франции, по ответу ChatGPT и переехала, ей повезло (CNN). Другие говорят «он галлюцинирует» и бросают. По-моему, ошибаются оба лагеря: дело не в модели, а в том, на что она опирается.
Почему модель угадывает
Обычный запрос: вы пишете вопрос, модель отвечает из своих весов. Веса — сжатый след всего, что она когда-то прочитала. В них нет ссылки на документ, нет даты, нет вашего контекста. Когда факт в весах «размыт», модель не говорит «не знаю», а достраивает наиболее вероятный ответ, такой же гладкий, как верный. Поэтому выдуманное дело и настоящее для неё устроены одинаково.
Из того же корня растут и рабочие неприятности. Просишь ТЗ для клиента без исходных данных и получаешь красивые страницы, которые ни на что не опираются. Похожая история на r/webdev: клиент прислал 20 страниц правок, написанных ChatGPT, и автор считает 80% из них нерелевантными (пост). Это один пост, не статистика, но узнаваемый.
Исправлять надо не модель, а условия: дать ей источники и требовать ответ только по ним.
Метод в пять шагов
Сначала реальная история. Человек выбирал, куда переехать. Спрашивать чат он не стал: собрал много видео, отдал их агенту, тот разложил всё в Obsidian, и у каждого факта осталась ссылка на видео. Спрашивал он уже не модель, а свою базу. По ответам переехал. Детали не раскрываю, но схему можно повторить.
1. Собрать источники, а не спрашивать. Я ставлю агенту Agent Reach: бесплатный открытый инструмент, который даёт агенту доступ к Reddit, YouTube, сайтам и поиску. Все истории выше для ролика нашёл агент, у каждой есть ссылка. Не всё подтвердилось: цифры Edelman в первоисточнике я не нашёл и убрал.
2. Разобрать видео. Одних субтитров мало: на экране часто показывают то, чего не произнесли. Я использую скилл, который режет ролик по сменам сцен и привязывает кадры к таймкодам.
3. Сложить в базу Obsidian по схеме Карпатого. Сырьё отдельно, выжимки отдельно, всё связано ссылками, у каждого факта поле «источник». Агент пополняет базу и проверяет её на противоречия. Мои прошлые наработки по памяти для агентов: Karpathy Wiki Bundle.
4. Спрашивать базу, а не модель. Агент отвечает только по базе и к каждой фразе даёт ссылку. Если в источниках нет, так и говорит. Как вариант можно загрузить источники в NotebookLM, он работает по тому же принципу, подробности в разборе NotebookLM × Claude Code. Это необязательный шаг.
5. Сверять с первоисточником. База защищает от выдумок модели, но не от ошибок самих источников. Пример: обзорщик заявил одно про место новой модели Gemini в рейтинге, а в самом индексе картина оказалась иной. Как я разбирал такие обзоры, описано в статье про Gemini 4 Argon. Любую цифру, на которой строится решение, открываю в оригинале.
Вывод
ИИ не врёт и не советует. Он продолжает текст, и качество продолжения зависит от того, на что он опёрся. Три случая из начала объединяет одно: никто не дал модели опору и никто не проверил ответ.
Свои заготовки я упаковал в набор ramas-research-kit: доработанная схема Карпатого, скиллы, инструкция по Agent Reach и один промпт, по которому агент разворачивает всё сам. Набор лежит в Telegram.
Где найти
- Видео: youtu.be/WiiADNCbE7c
- Telegram-канал «Рамас. Лаборатория»: t.me/ramas_lab